第 4 次课 · 逻辑型数字化世界:数值、文本与矢量图形编码(10.13/10.14)
本课进入模块 2「信息的表示与处理」。上次课搭的加法器只会做 0/1 变换,并不知道这串 0/1 代表什么,含义是人给的。信息来自可感知、可区分的状态差异,所有信息进计算机之前都要先数字化。逻辑型数字化由人定好编码规则,把符号映射成 0/1。课上讲三类编码:数值(补码、浮点数)、文本(ASCII、GB2312/GB18030、Unicode/UTF-8)和矢量图形(SVG)。最后动手改一段 SVG,把圆和矩形做布尔运算再旋转。
页面完善中
本页部分内容(课程视频、课堂回放等)仍在制作,上线后会陆续补齐;课件与练习素材已可查看。
📺 课程视频
课堂录像已按小节切分,同一小节可在 Bilibili 或抖音观看。
第一小节:打开计算机硬件的盲盒(李秀)
第二小节:信息表示与处理(李秀)
📄 课件
课件说明
本课课件「信息表示与处理(一)」有新版和旧版,内容只有一些细微差别。新版补了“什么是信息”、比特的存储载体、“编码是工程权衡”的小结等。课件里还附了课堂要用的两样东西:一段 UTF-8 乱码文本,一组 SVG 矢量图形。
信息表示与处理(一)· 新版
这是新版
新版在旧版基础上做了微调。课件拆成「打开计算机硬件的盲盒(回顾)」和「信息表示与处理」两部分,可分别下载或预览。
第一部分 · 打开计算机硬件的盲盒(回顾)
第二部分 · 信息表示与处理
需要完整课件的话,可下载新版完整版 PDF。
信息表示与处理(一)· 旧版
第一部分 · 打开计算机硬件的盲盒(回顾)
第二部分 · 信息表示与处理
需要完整课件的话,可下载旧版完整版 PDF。
乱码示例:不是文件坏了,是解码规则用错了
乱码-UTF8.txt 用 UTF-8 保存。换用 GB18030 去解读同一串 0/1,得到的就是无法识别的字符。
你看到的这类乱码,并不是二进制数据损坏,而是使用了错误的编码字典去解码:一段文本原本用 UTF-8 编码保存,如果用 GB18030 规则来解读这段 0/1 序列,就好比拿着《英汉字典》去查询日文,自然得到无法识别的字符,也就是乱码。
SVG 矢量图形素材
课堂练习要在文本编辑器里直接改 SVG 描述。先看两个最基础的图元,圆和矩形。
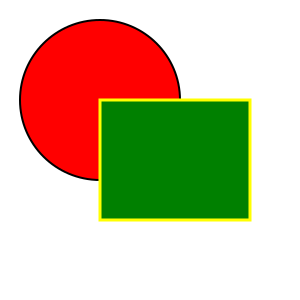
练习 1 是在圆的绘图描述里新增一个矩形图元,渲染器按先后顺序叠加绘制圆与矩形,得到上面这种叠加画面。
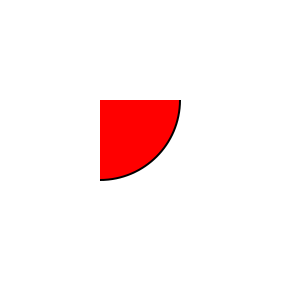
把图形组合起来还能用布尔运算。clip-path 得到相交,只保留裁剪区里的部分:
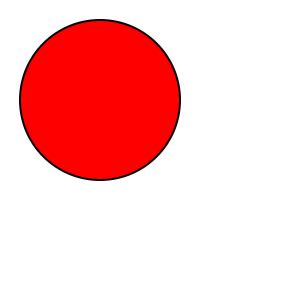
mask 得到相减,把矩形从圆里挖掉:
练习 2 · 布尔差集与旋转(参考实现)
任务:修改 SVG 绘图描述,对圆和矩形做布尔差集(圆减去矩形),再把结果整体逆时针旋转 45°,得到右侧缺口扇形。
参考实现(在 相减运算.svg 的基础上,用 <g> 分组加旋转):
<svg width="300" height="300" xmlns="http://www.w3.org/2000/svg">
  <!-- defs:定义遮罩规则,实现圆减去矩形 -->
  <defs>
    <mask id="cutMask">
      <!-- 白色矩形:全部保留区域 -->
      <rect x="0" y="0" width="300" height="300" fill="white"/>
      <!-- 黑色矩形:这个区域透明,用来挖掉圆的一部分 -->
      <rect x="100" y="100" width="150" height="120" fill="black"/>
    </mask>
  </defs>
  <!-- g 分组:把图形打包成整体,添加变换规则:整体逆时针旋转 45°,旋转中心 (100,100) -->
  <g transform="rotate(-45,100,100)">
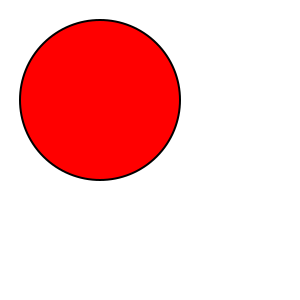
    <circle cx="100" cy="100" r="80" fill="red" stroke="black" stroke-width="2" mask="url(#cutMask)"/>
  </g>
</svg>
渲染效果:
📝 作业
本次课没有新作业。作业 2 的实验报告上次课后就布置了,还没交的同学按第 3 次课的要求完成,提交 硬件实验_学号.pdf。
🎬 课堂回放
完整课堂实录,可选择任意课堂观看。
2-1 课堂(周二 第一大节 · 自强楼 5312):
若在线播放卡顿,可点此直接下载录像。
3-3 课堂(周三 第三大节 · 自强楼 5310):
若在线播放卡顿,可点此直接下载录像。
🗂️ 课程内容摘要
这节课接着上次课的加法器往下讲。硬件只会做 0/1 变换,不知道 0/1 的含义;含义来自人定的编码规则。课上先讲比特在运算和存储里的两种角色,再说清什么是信息、感知型和逻辑型两类数字化。之后依次是数值编码、编解码的配套关系、文本编码和矢量图形编码,最后收在「编码是工程权衡」上。
第 0 部分 · 承接上次课:比特的两种角色
比特在硬件上有两种用法。看电路时不妨换个视角:与其盯着串联、并联怎么接,不如把电路看成一个封装好的 \(y=f(x)\)。别被连线拓扑干扰,只关注给什么输入、得到什么输出。逻辑门封装的正是连线拓扑所表达的符号变换规则。一个比特对应一位二进制数,在电路里就是高低电平、开关通断。
运算硬件里,比特是瞬时的高低电平,用来实时做符号变换。衡量并行运算能力的是位宽,64 位 CPU 指 ALU 一次能并行处理 64 个比特。位宽不够时就会出问题。两位加法器能算 3+2=5,却算不了 1+4,因为 4 的二进制 100 需要三位,输入引脚根本不够。要算 253+5,至少要 8 个全加器级联,输出还可能多出一位进位,共 9 位。实验搭的是串行进位加法器,高位必须等低位的进位,本质是串行计算;真实 CPU 用超前进位等方案,通过逻辑提前算出各位进位,实现并行计算。课上不展开超前进位,是因为逻辑太复杂,重点在建立「串行/并行」和「位宽」的概念。
存储硬件里,比特是可维持的物理状态,用来保存比特序列。只要能稳定表示两种状态的电路或介质,都能拿来存比特:
- SRAM(静态内存):用 6 个晶体管构成双稳态触发器保存 1 比特,通电时状态稳定、不用刷新;电路复杂、面积大、成本高,速度快,用作 CPU 高速缓存。
- DRAM(动态内存):用 1 个电容加 1 个开关记录 1 比特,电荷每 10~100 毫秒会流失,需要周期性刷新;单元简单、密度高、成本低,用作电脑主内存,断电会丢数据。两者都属于易失性存储。
- 磁盘靠磁粒子磁化方向记录比特,写入后排列方向不再改变,断电仍能保留,但怕强烈震动;闪存(NAND)靠浮栅晶体管俘获电子记录比特,也能断电保留。
- 固态硬盘 SSD 以闪存芯片为存储颗粒,配上读写主控电路,没有机械读写头,存取比机械硬盘快,也更防震,成本降下来后成为主流。
存储容量以字节为基础,1 字节 = 8 比特是历史形成的标准;容量按 1024 递进:KB、MB、GB、TB、PB、EB。买电脑说的「16G 内存」和「1T 硬盘」是两类不同用途的存储。编辑时数据在内存里,随时可能因为断电消失;点「保存」是把内存里的数据写回硬盘等非易失存储。课上用「赶作业到 23:59,一杯咖啡泼到电脑上黑屏」的场景解释易失性。
把 8 位加法器封装成芯片,只留下输入输出引脚。集成工艺把晶体管和连线「微雕」到硅片上。ENIAC 占一间教室;今天的笔记本和手机性能强百万倍,尺寸小几十万倍,价格也从举国之力变成个人可拥有。这些变化靠的是半导体材料和集成电路工艺。单位面积晶体管数大约每 18–24 个月翻一番、成本下降,这就是摩尔定律;先进制程已到 2 纳米左右,硬件迭代放缓,进入后摩尔时代,但应用层的生成式 AI、通用人工智能仍在快速推进。
回到计算模型:它的基础动作就是条件判断(布尔逻辑)和符号变换。硬件连线拓扑决定了固定的变换规则 \(f\),给一组 0/1 输入 \(x\),就输出一组 0/1 \(y\)。但硬件不知道这串 0/1 是数字、文字还是图形。要让硬件处理不同的信息,有两条路:改 \(f\)(重新接线,换电路拓扑),或者改编码规则(\(f\) 不动,只改 0/1 的含义)。本课走第二条。
第 1 部分 · 信息与数字化
信息来自可感知、可区分的状态差异。香农说,信息用来消除不确定性。讲台上摆着三台电脑:Windows 笔记本、Mac、台式机。你能分清它们,是因为形状、大小、材质、界面这些差异。差异消除了「这是哪台电脑」的不确定性,这就是信息。按来源分两类:
- 感知得来的物理信号。声音、图像、压力这类连续物理量。
- 人类抽象创造的符号系统。数字、文字、几何图形这类有限、离散的符号,用来更高效地加工、存储、分享和推理。
所有信息进计算机前都要数字化,但两类信息的走法不同:
- 感知型数字化。对连续物理信号采样、量化,得到一组有限的离散数值,这是对真实世界的近似,再把数值编码成 0/1。位图图像、音频、视频属这一类,还原出来是近似值(位图放大会失真)。
- 逻辑型数字化。对人类抽象符号,直接按人预先定好的规则编码映射成 0/1。硬件只认 0/1,含义、语义、结构都由编码规则赋予。数值、文本、矢量图形都算这一类,表示本身是无损的(矢量图形可无限缩放)。
课上留了一个问题:为什么不同类型的信息要用不同的编码方案?答案在信息本身的结构。结构不一样,工程上要的东西也不一样:硬件怎么做运算、存储要多大、传输快不快、解码难不难,这些都得一起考虑。
第 2 部分 · 数值编码:从进位制到补码与浮点数
- 二进制进位计数制。基数是 2,每位只有 0 或 1,逢二进一;位置有权值,从右向左第 \(i\) 位权重为 \(2^i\)。例如 \((1101.11)_2 = 1\times2^3+1\times2^2+0\times2^1+1\times2^0+1\times2^{-1}+1\times2^{-2} = (13.75)_{10}\)。
- 减法能不能复用加法电路。\(8-4\) 能不能写成 \(8+(-4)\)?可以像加法器一样再搭一套减法电路,但工程师更希望复用已有的加法硬件,于是问题就变成「负号怎么编进 0/1 里」。
- 朴素符号位编码(符号 - 真值法)。最高位表示符号(0 为正、1 为负),其余是数值位。看着很自然,可 8 位只能表示 \(-127\) 到 \(+127\),而且有
+0和-0两个零;更麻烦的是,+5加-5按这套规则算出来不是 0,而是类似-10的结果,加法器直接把符号位也当数值加了。 - 补码规则(模运算)。模是一个计量系统的量程。定了模,总能找到一个正数来代替负数,这个正数就是负数的补数。拿钟表打比方:12 小时制有 12 个状态,模是 12;指针从 6 拨到 2,逆时针 4 下是减法,顺时针 8 下是加法,所以 \(-4\) 和 \(+8\) 在模 12 下等价,\(6-4\) 可以写成 \(6+8=14\),去掉溢出的一圈 12,剩下 2。以 8 位为例,模是 256,\(-5\) 的补码是
11111011;\(5-5\) 变成 \(5+(256-5)=256\),最高位的 1 被丢掉,结果是 0。 - 补码的编码与解码。正数的补码和原码(真值)一样;负数的符号位固定为 1,数值位按位取反再加 1。解码反过来:正数直接读数值位;负数整体按位取反加 1 得到原码,再按符号位读真值。补码是固定位宽模空间下的工程编码,让计算机只用加法电路就能做带符号整数的加减。课堂还现场算了建校周年:约定年份用 4 位、模 10000,\(-1911 \equiv 10000-1911=8089\),于是 \(2026-1911\) 变成 \(2026+8089=10115\),丢掉最高位得
0115,即 115 周年;由同学上台完成了这个推导。 - 浮点数编码。补码是定点整数,表示不了极大或极小的实数,比如宇宙年龄 138 亿年、普朗克时间 \(10^{-44}\) 秒。十进制科学计数法写作 \(N = m \times 10^e\),二进制浮点数就是 \(N = (-1)^s \times m \times 2^e\),小数点通过指数调整位置,所以叫「浮动」。以 32 位单精度浮点数(IEEE754)为例,32 位分成 1 位符号、8 位指数、23 位尾数三段,指数管范围、尾数管精度。定点加法器复用补码就能做加减,乘除可以看成连续加/减;但浮点数规则不同,没法直接复用定点电路,所以 CPU 要有专门的浮点运算单元,买 CPU 时看到的「浮点运算性能 / FLOPS」就是指这项能力。
第 3 部分 · 编码与解码:一对配套动作
- 编码是把信息翻译成机器能处理的符号;解码是把机器里的符号还原成人能看懂的信息。
- 加法器实验、补码运算、浮点数、ASCII 字符、SVG 矢量图形,走的都是「编码 → 硬件处理 → 解码」这一套。
- 规则由人定,编码和解码要用同一套规则,否则就是乱码或者解析出错。
第 4 部分 · 文本编码:ASCII、GB2312/GB18030 与 Unicode/UTF-8
编码就是建立一套唯一、无歧义的映射:先确定字符集,再在编码空间里给每个字符一个编号,最后把编号转成二进制。
- ASCII(1963 年)。收了 128 个符号,人为排成 16 行 × 8 列,16 行对应 4 位二进制、8 列对应 3 位二进制,合起来 7 位正好定位 128 个符号,这个位置编号就是字符的二进制串。存储时占 1 字节,最高位补 0;如果当年字符集更大,字节也可能被约定成 16 位,标准是根据工程需要塑造的。
- GB2312(1980 年)。国标汉字编码。汉字 6763 个,一级 3755 个按拼音排,二级 3008 个按部首排;另有 682 个非汉字,包括拉丁字母、日文假名、俄文字母和标点。定位用 94 区 × 94 位的区位码,像切豆腐块一样给每个汉字一个坐标,比如「中」在 54 区 48 位,区位码就是 5448。
- GB18030(2000 年)。GB2312 的扩展(中间还有一步 GBK,1995 年)。GB2312 只收了 6763 个汉字,生僻字、繁体字和少数民族文字都放不下;名字里有生僻字时,早年教务系统只能显示星号,朱镕基的「镕」字不在字库里,报纸排版时只好把这个字做成图片嵌进去。GB18030 在它们的基础上继续扩充,能表示全部 Unicode 码位,并向下兼容 GB2312 和 GBK,编码长度有 1、2、4 字节三种。这个标准还在更新:2005 年出过一版,现行的是 GB18030-2022(2023 年 8 月 1 日起实施),继续补充字符、修正映射。
- Unicode 和 UTF。Unicode 把世界上的文字、符号收进一本总表,每个字符给一个全球唯一编号,省得各国各搞一套编码表。如果总表直接按固定 4 字节存,英文
A也会从 1 字节膨胀到 4 字节;UTF 是 Unicode 的存储实现,后缀数字是编码的基础单元大小。UTF-8 变长,按字符频率用 1~4 字节表示一个字符:英文兼容 ASCII,占 1 字节,常用中文占 3 字节,兼顾兼容性和效率。同一套 Unicode 字符集,也能改用 UTF-16 等编码。
第 5 部分 · 矢量图形编码:SVG 的图元与参数
- 图形的基础形状有限(圆、矩形……),但位置、大小、颜色能组合出无穷多种。
- 编码方式是图元加参数:图元说明是什么形状,参数说明位置、大小、颜色。几何规则配上具体参数,才能确定图形长什么样。
- SVG 由两部分组成:矢量逻辑编码(业务语义)和 UTF-8 编码(文件存储)。它是文本,所以记事本能打开;渲染器读绘制说明,算坐标,画图。
- 改矢量图形不用动像素,只加几何运算规则和变换参数,改的是绘图描述文本。
clip-path做相交,mask做相减,<g transform="rotate(...)">做旋转。 - 渲染器读全部几何规则,实时算坐标重画。放大缩小只是换个比例重画,图形不会失真。课堂上现场演示了
circle.svg:双击默认被浏览器打开,因为浏览器内置渲染器;想用记事本看源码,要在「文件 → 打开」里把文件类型改成「所有文件」才能选中它。把 SVG 插入 PPT,PPT 的渲染器会按描述画图;改一下fill再重新插入,颜色就变了。这直观说明:矢量图形文件存的是绘图描述,不是像素。
第 6 部分 · 小结:编码是工程权衡
逻辑型数字化的核心动作就是编码:把人类抽象符号映射成 0/1 比特串交给硬件,解码再把 0/1 还原成符号语义。编码没有万能方案,要同时适配硬件运算特性、表达范围、存储开销、传输效率和解码复杂度。这也是不同信息要用不同编码的原因:
- 数值用补码。为了复用加法硬件。
- 数值用浮点数。为了表达极大、极小的数值,需要专门设计运算电路。
- 文本用 Unicode/UTF-8。为了统一表示多国文字,同时兼顾存储大小和兼容性。
- 图形用 SVG。用图元(几何规则)加参数(尺寸、位置等)描述几何概念,缩放不失真。
核心概念
| 概念 | 要点 |
|---|---|
| 信息 | 建立在可感知、可区分的状态差异上,用来消除不确定性 |
| 逻辑型数字化 | 人定规则,把符号映射成 0/1,语义由规则赋予 |
| 感知型数字化 | 采样、量化连续世界,得到近似值再编码,有损 |
| 补码 | 固定位宽模空间里把负数换成等效正数,加法器兼做减法 |
| 浮点数 | \(N = (-1)^s \times m \times 2^e\),符号位、指数位、尾数位 |
| 编码 / 解码 | 同一套规则成对使用,否则乱码 |
| ASCII | 7 比特、128 个符号,存 1 字节、最高位补 0 |
| Unicode / UTF-8 | 全球唯一编号,变长存储(1~4 字节) |
| SVG | 图元加参数的绘图描述,以 UTF-8 文本存储 |
| 编码是工程权衡 | 适配硬件运算、表达范围、存储开销、传输效率、解码复杂度,没有万能编码 |
✅ 课堂思考与判断
下面几道题可以自测,点开看答案。
1. 逻辑型数字化和感知型数字化有什么根本区别?
逻辑型:人定规则,把符号映射成 0/1,含义由规则赋予,表示无损。感知型:对连续世界采样、量化,得到的是近似值,有损。
2. 把 \((1101.11)_2\) 化成十进制是多少?
\(1\times8+1\times4+0\times2+1\times1+1\times0.5+1\times0.25 = 13.75\),即 \((13.75)_{10}\)。
3. 用符号 - 真值法表示负数,为什么加法器会算错?
符号位和数值位被当成同一套加法规则处理,正负号没有参与模运算,于是加法逻辑混乱、出现两个 0,负数相减还要单独做电路。
4. 8 位补码里,-5 的补码是多少?为什么它能复用加法器?
-5 的补码是 11111011。8 位模是 256,\(-5\) 和 \(+251\) 在模 256 下等价,\(5+(-5)\) 变成 00000101 + 11111011 = 100000000,丢掉溢出的最高位就是 0。这样减法 \(a-b\) 能写成 \(a+(-b)\),统一交给加法器。
5. 用补码规则,怎么只用加法算出 2026-1911?
约定年份表示 0~9999,取模 10000,\(-1911 \equiv 8089\)。\(2026+8089 = 10115\),丢掉最高位得 0115,也就是 115。清华 1911 年建校,2026 年正好 115 周年。
6. 为什么还要有浮点数编码?
补码是定点整数,表示不了极大(如宇宙年龄 138 亿年)或极小(如普朗克时间 \(10^{-44}\))的实数。浮点编码类比科学计数法 \(N=(-1)^s\times m\times2^e\),用符号位、指数位、尾数位三段表示,范围大,也有精度。
7. ASCII 只用了 7 位,为什么存储时要占 1 字节?
一个字节(8 位)是计算机存储计量的基础打包单位。7 位编码放进一个字节,最高位补 0 就行。这空出来的第 8 位后来也没浪费:ISO-8859-1(Latin-1)用它表示西欧语言的带音标字母,把码位扩到 256 个,前 128 个和 ASCII 完全一样。
8. 同一段 UTF-8 文本,为什么用 GB18030 解码就会乱码?
0/1 本身没有含义,编解码得用同一套规则。UTF-8 和 GB18030 里,字符和字节的对应关系不一样,同一串 0/1 换另一套规则去读,就会被拆成别的字,得到乱码。
9. SVG 的 circle 图元描述,是编码还是编程?
它属于编码:图元(是什么形状)加参数(位置、大小、颜色)的结构化描述。说它像编程,是因为渲染时会按几何规则实时算坐标;但它本身是数据描述,不是可执行程序。
10. 为什么 SVG 放大不失真,位图放大会有马赛克?
SVG 存的是几何规则和参数,渲染器在每个比例下重新算坐标绘制,不依赖固定像素;位图存的是固定像素点阵,放大只是把像素拉大,所以出现马赛克。