第 2 次课 · 字处理软件底层逻辑与结构化排版 · 从人类计算师到数字电子计算机(9.22/9.23)
本课有两小节。第一小节承接上一次课,从双击一张照片说起,看操作系统和应用软件各自做了什么,再落到字处理软件的四类对象和长文档排版,作业 1 的 Word 排版会用到。第二小节引入下一节课,从计算的本质 \(y=f(x)\) 讲到图灵机、通用图灵机和冯·诺依曼架构,最后用电子开关搭出逻辑门,为二进制加法器实验做铺垫。
📺 课程视频
课堂录像已按小节切分,同一小节可在 Bilibili 或抖音观看。
第一小节:字处理软件 · 打开应用软件的盲盒(李秀)
第二小节:从人类计算师到数字电子计算机(李秀)
📄 课件
课件说明
本课课件分为「字处理软件」与「计算与数字电子计算机」两份 PDF,各课堂共用同一份,可直接在线预览或下载。下面还附上「双击照片」的现象说明和「文章排版讲义与示例」。
字处理软件:打开应用软件的盲盒
计算与数字电子计算机:打开计算机硬件的盲盒
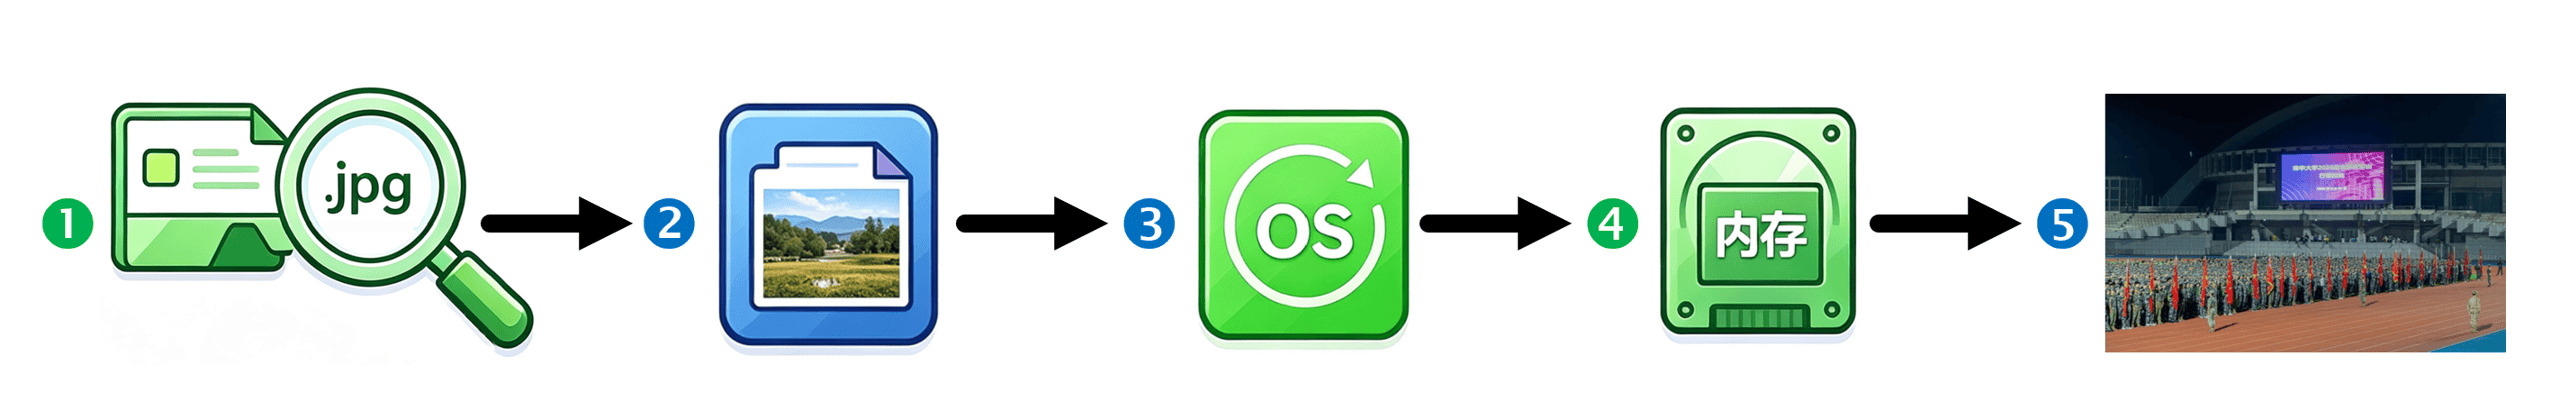
双击一张照片后,系统里发生了什么
以 D:\开学\军训照片.jpg 为例,双击打开它时,操作系统与应用软件会接力完成 5 个步骤:
- 操作系统查到该文件的管理信息;
- 根据后缀
.jpg匹配关联的应用程序(看图软件),并启动它; - 看图程序调用操作系统提供的读写接口,发出读取请求;
- 操作系统从磁盘上读取文件本体的比特流,把原始 0/1 数据加载进内存;
- 看图程序按 JPG 格式规则解析比特流,把 0/1 还原成像素画面并绘制(渲染)到窗口。
文章排版讲义与示例
《文章排版示例》是字处理软件的讲义文字版,也是一份可以直接照着练的结构化排版示例。下面是内嵌预览,可以滚动看全文;正式课件以上方 PDF 为准。
字处理应用软件
应用软件的学习,不在于死记硬背按钮和菜单操作,而是要理解软件的底层逻辑,建立正确认知,获得软件学习迁移能力。无论软件版本怎样更新,不管切换到 Word、WPS 文字或是在线文档,我们都可以快速上手适应。
一、什么是字处理软件
字处理软件是用于文字录入、对象插入、内容编辑、格式排版、页面输出的专业文档工具。和普通的纯文本工具(记事本)不同,字处理软件不仅保存看得见的文字内容,还会保存隐藏的排版格式和页面版面信息,能够实现图文混排、精细化文档排版。
【课堂操作提示】新建空白文档:新建文档时,在没有输入内容之前,Word/WPS 默认套用 `Normal.dotm` 模板。文档窗口看起来是空文档,但已经继承模板预设的排版渲染规则(字符、段落、页面的默认格式)。
二、软件处理的对象
1、字符(文档最小处理单位)
字符是字处理软件的最小处理单位。字符分为两类:
1)可打印字符:肉眼能够直接看到的中文字符、西文字符、数字以及各类标点符号(注意:中文与西文符号字符的占位宽度不一样,很多排版对齐问题由此产生),主要用来承载文章正文内容。
2)非打印字符:属于软件的排版控制标记。平时默认隐藏、打印输出时不会显示,但是决定了文档的基础结构和排版规则,常见的有空格、制表符、换行标记、段落标记和分页符。
【课堂操作提示】点开「显示 / 隐藏编辑标记」¶ 按钮,查看:空格、制表符、手动换行标记、段落标记、分页符。
2、段落(文档逻辑核心对象)
段落是字处理软件真正的逻辑核心对象。按下回车键就会生成段落标记 ¶,创建一个全新的独立段落。
段落的全部格式设置,包括首行缩进、对齐方式、行间距、段前间距、段后间距、左右缩进,甚至大纲级别,全部保存在段落标记 ¶当中。
【课堂演示重点】如果删除段落标记 ¶,相邻两段会合并为一个段落,格式随之融合。这是排版最核心底层规则。
3、非文本复合对象(图文混排核心)
除了字符、段落这类纯文本对象以外,字处理软件还支持插入外部多媒体与复合对象。典型代表:图片、表格、数据图表、形状、文本框等。
【课堂操作提示】演示插入图片,修改环绕方式。所有外部对象,可独立设置大小、位置、环绕方式、对齐样式,和文本段落自由搭配,实现图文混排。
4、页面(文档输出物理容器)
所有文字与图文对象,最终依托页面介质完成预览和打印输出。页面设置包含纸张大小、页边距、页眉页脚、页码等版面参数。纸张与页边距划定的版心,约束文字和各类对象的摆放范围。
文档内容填满版心右边界,软件自动换行(自动换行只是视觉分行,不会产生任何标记)。
快捷键 Shift + 回车 是手动强制换行,只改变屏幕显示的行,不生成新段落。内容填满版心会自动分页,也可以手动插入分页符强制开启新页面。
【课堂操作提示】打开页面设置,修改页边距,观察版心变化,对比自动换行与 Shift + 回车手动换行的区别。
三、.docx 格式文档中保存了哪些信息
docx 文档并不只存储文字,一共保存三类信息:
1、内容本体信息:内容本体信息是文档核心正文与素材,承载文章语义,是文档主体数据。
2、格式修饰信息:格式修饰信息是附着在文档对象上的排版样式信息,分为字符级格式和段落级格式。
字符级格式:针对单个文字生效,包含字体、字号、颜色、加粗、字符间距等。
段落级格式:针对整个段落生效,包含缩进、行距、对齐方式、段前、段后间距;同时也包含图片、表格的环绕方式、尺寸样式等。
这类信息大多隐藏在非打印标记和对象属性中,肉眼看不见,但会永久保存在 docx 文件容器内。
3、物理版面信息:面向打印输出的页面规则,划定整篇文档排版边界。包含纸张大小、页边距、版心范围、页眉页脚、页码、分页规则。版面信息直接决定文字如何换行、内容在哪里分页,确定文档最终输出形态。
四、长文档的结构化排版
日常短文档仅需要简单的字符、段落、页面排版,但是毕业论文、工作报告、书稿这类长文档,对文档有明确要求:结构层次清晰、全文格式统一、能够自动生成目录、修改内容后格式可以批量同步更新。
很多初学者习惯手动修改字体字号、依靠空格做对齐、敲回车空行来调整间距。这套做法只适合很短的文本,放到长文档中,很容易出现格式不统一、层级混乱,修改一处就造成全篇排版错乱。问题根源就是缺少结构化排版思维。
想要真正实现结构化排版,必须分清两个容易混淆、相互独立,但又可以建立关联的核心概念:大纲层级属性和样式格式体系。
1、大纲层级属性:文档的「逻辑结构」
大纲层级是绑定在段落上的逻辑层级编号,只用来标记文档上下级结构,属于段落的结构属性,本身不会改变字体、字号、行距这些外观样式。

大纲级别是段落对象的属性,可以在【段落】设置面板直接设置
段落的大纲级别可以在【段落】对话框直接设置,在大纲视图下会看得更加直观。每个段落可以分配不同层级:1 级、2 级、3 级…… 以及正文文本。1 级是最高层级,一般对应文章一级大标题;2 级隶属于 1 级,对应二级小标题,以此类推。
大纲层级的作用:让软件读懂文档逻辑骨架,用来折叠或展开章节、自动提取生成目录、设置自动章节编号、拖拽调整整篇文章章节顺序。
一句话概括:大纲层级只管文档结构,不负责页面美观。
【课堂操作提示】切换大纲视图,选中段落,修改段落的大纲级别,观察视图变化。
2、样式体系:文档的「格式模板」
样式是一套提前定义好的成套格式模板,里面同时保存一套字符格式 + 段落格式,负责控制文档外观。内置样式如:标题 1、标题 2、正文。
用样式的核心优势:不再逐段手动调格式。全文同类内容套用同一个样式,格式保持统一;后续只修改一次样式参数,文档内所有应用该样式的段落,自动同步更新,解决长文档重复修改、格式混乱的问题。
一句话概括:样式只管外观格式,不直接定义文档逻辑结构。
3、样式关联大纲层级(本次课难点)
重点理解:大纲层级属于段落本身属性,样式只是预设好的格式模板,二者天生相互独立。
举例:可以给段落套用「标题 1」样式(外观是大标题),但把段落大纲级别设置为正文文本。此时外观是标题,但软件识别不到它是文档标题,无法自动提取到目录。
所谓样式绑定大纲层级:编辑样式时,在样式的段落属性里,预先设置对应的大纲级别。当段落应用这个样式,段落就自动获得对应的大纲级别。
常规做法:标题 1 样式绑定 1 级大纲,标题 2 绑定 2 级大纲,正文样式绑定正文层级。
绑定之后,段落套用样式,同时获得外观格式 + 文档逻辑层级,既统一全文样式,也建立文档骨架,支持自动生成目录,实现专业长文档排版。
4、长文档结构化排版通用流程(实操顺序)
1. 整理文档文字、图片等素材
2. 设置页面版面参数(纸张、页边距)
3. 修改 / 新建样式模板
4. 在样式内绑定对应大纲层级
5. 为所有段落统一套用样式
6. 局部微调字符格式、图片表格等复合对象
原则:坚决摒弃「空格对齐、多余回车空行、逐段手动修改格式」的不良排版习惯。
📝 作业
本次课没有新作业。作业 1 的 Word 排版正好用上本课讲的字符、段落、页面和样式,写完按第 1 次课的要求提交 cca_学号.docx。
🎬 课堂回放
完整课堂实录,可选择任意课堂观看。
2-1 课堂(周二 第一大节 · 自强楼 5312):
若在线播放卡顿,可点此直接下载录像。
3-1 课堂(周三 第一大节 · 自强楼 5312):
若在线播放卡顿,可点此直接下载录像。
🗂️ 课程内容摘要
第一小节接着上次课的文件概念往下讲:文件怎么被软件读出来,字处理软件到底在排什么。第二小节为下一次课的电路实验做准备,从「计算是什么」讲到图灵机、通用计算机和电子开关。
第一小节:打开应用软件的盲盒 · 字处理软件底层逻辑与结构化排版
上一课留下一个等式:文件 = 文件名 + 后缀 + 路径 + 一串二进制 0/1 数据。这串比特本身没有语义。比特没有标签,文件格式才是约定「怎么解读这串比特」的规则,后缀只是格式的提示;每款应用软件只认自己那套格式。用记事本打开 .jpg 看到乱码,不是图片坏了,只是解读规则用错了。真正的内容,是应用软件按文件格式把比特流还原出来的。
后缀只是给操作系统看的外部标签,真正的文件格式写在数据流内部,是应用软件保存时按协议写进去的。把 .docx 直接改名成 .pdf 并不会真的变成 PDF,打开时照样可能乱码或格式错乱;要转 PDF 得用「另存为 / 导出」让软件重新按 PDF 协议组织数据。文件复制到另一台电脑时,盒子里的数据本体不变,文件名、路径、系统时间、权限这些外部标签可能变;JPG 里记录的相机型号、拍摄时间属于数据本体,复制后仍然保留。Word、WPS、在线文档都能打开 .docx,是因为它们内部都嵌入了能解析 docx 格式的代码;另存为 .txt 时 Word 会弹窗提醒「会丢失格式」,就是格式与内容分离的直观证据。
打开文件时,操作系统和应用软件各有分工。操作系统像管家,定位路径、读取文件的容器信息、找到该用哪个程序,再把磁盘上的比特流搬进内存。应用软件负责翻译和渲染,按对应格式解析比特流,画成能看懂的图片或文字页面,并让你编辑。换个角度看,文件分成里外两层:外层的文件名、后缀、路径、系统时间、权限等元数据由操作系统维护;里层的数据流,包括格式元数据、排版规则、正文内容,由应用软件维护。
字处理软件用来录入文字、插入对象、编辑内容、排版和输出页面。与其背按钮,不如弄清底层对象,这样换到 Word、WPS 文字或在线文档都能快速上手。它主要处理四类对象:
- 字符。文档的最小单位,分可打印字符和非打印字符。前者是看得见的中英文、数字和标点;后者是空格、制表符、换行、段落标记、分页符这些隐藏的排版标记。
- 段落。字处理软件真正的逻辑核心。按回车就会生成段落标记
¶,首行缩进、对齐、行距、段前段后、大纲级别等格式全都存在这个¶里。删掉¶,相邻两段会合并,格式也跟着融合。 - 非文本复合对象。图片、表格、图表、形状、文本框,各自都能设置大小、位置和环绕方式,用来做图文混排。
- 页面。纸张大小、页边距、页眉页脚、页码这些输出参数。内容填满版心会自动换行,那只是屏幕上的分行,不产生标记;
Shift + 回车则是手动换行,同样不生成新段落。分页有自动的,也可以手动插入分页符。
课堂上还演示了几个很实用的操作:Ctrl + 鼠标滚轮 缩放视图,视图里可切多页或单页;布局里改纸张大小(默认 A4,表格要求 B5 就改 B5)和页边距,差两三行甩到下一页时可以用「自定义页边距」微调,不必硬删内容。交作业前打开「开始」里的 ¶,空格、制表符、手动换行、段落标记、分页符都会显形,能发现多余空行和用空格凑出来的对齐。中文标点 !。、,: 和西文标点 !.,: 占位宽度不同,很多「怎么都对不齐」的问题就出在这里,不要用一串空格去凑。某个词或句号被挤到下一行时,可以选中它,在「字体 → 高级 → 间距」里设「紧缩」 0.1–0.2 磅,往往就能收上来。正文常用首行缩进 2 字符、段前段后各 0.5 行、行距 1.2 倍;删掉段落标记 ¶ 后两段合并,段落级格式跟着合并,但原先单独设置的字符格式(比如某段是楷体)可能保留。
.docx 不只存文字,它保存三类信息。一是内容本体,也就是正文、图片、表格这些素材。二是格式修饰,分字符级(字体、字号、颜色、加粗、字间距)和段落级(缩进、行距、对齐、段前段后,以及图片表格的环绕和尺寸)。三是物理版面,包括纸张、页边距、版心、页眉页脚、页码和分页规则。纯文本 .txt 只存第一类,所以记事本算不上字处理软件。WPS 是 Word Processing System 的缩写,最早就是字处理软件,后来才扩展成 W(文字)、P(演示)、S(表格)等办公套件,苹果的 iWork 也是对标这一套。Word 最终面向纸张和打印,所以基础容器是「页」;PowerPoint 最终面向屏幕展示,基础单位是「幻灯片」。
毕业论文、工作报告这类长文档,要求层次清楚、全文格式统一、能自动生成目录,而且改一处就能批量同步。不少初学者习惯手动改字体字号、用空格对齐、敲回车空行调间距,短文本还凑合,一旦变长就会出现格式不统一、层级混乱,改一个地方全篇乱套。根子在于缺少结构化排版思维。这里要分清两个概念:
- 大纲层级是段落上的逻辑编号(1 级、2 级、3 级……或者正文),只表示上下级关系,不改字体字号行距。它用来折叠展开章节、自动生成目录和编号,也能拖动调整章节顺序。
- 样式是一套预设好的格式模板,同时含字符格式和段落格式,比如「标题 1」「标题 2」「正文」。它管外观,不管逻辑结构。同类内容套同一样式就能统一,改一次样式全文同步。
- 把两者绑起来:编辑样式时,在段落属性里预设好大纲级别,段落套上样式后,外观和层级就一起拿到了。常见做法是「标题 1」绑 1 级大纲,「标题 2」绑 2 级大纲,正文绑正文层级。这样既统一了外观,也搭好了文档骨架,目录可以自动生成。
改样式和逐段改格式,差别在演示里看得很清楚:把「标题 1」改成黑体 + Arial、2 号、加粗、居中,所有套用该样式的标题一起变;再把标题颜色改成浅蓝,全文标题同步变色,不用格式刷一个个刷。正文样式常用楷体 + Times New Roman、5 号,一级标题 4 号。样式分段落样式、字符样式、链接样式三种;课堂新建的字符样式「提示强调」只给选中的几个字加蓝色底纹和白字,说明字符样式只作用于局部字符。大纲级别则要在段落对话框里设,不是在样式里「看起来像标题」,切到大纲视图就能折叠、展开、拖动章节。
排版的顺手顺序大概是:整理文字图片,设置页面参数,改好或新建样式,在样式里绑定大纲级别,给段落统一套样式,最后再微调字符格式和图片表格。空格对齐、多余回车空行、逐段手动改格式这些习惯,最好早点丢掉。
课上点评了一位同学的作业。内容质量很好,附录没有把 AI 对话整段复制或截图,而是每一轮都写了自己的甄别、判断和总结。AI 给出「应用程序沙盒」这个术语,他觉得零基础读者看不懂,就改写成「储物柜」。他还会让 AI 帮忙检查文章哪些内容容易过时。人主导的 AI 协作,大概就是这样。
常见排版错误集中在图片和标题上。插入的图片默认是「嵌入型」,会被当成一个大字符,跟着正文首行缩进往右错位。改成「浮动型」又可能跑到页边距外,打印时被裁掉。建议图片用嵌入型、居中,再适当缩小。标题太长或带逗号时,可以缩短标题,用 Shift + Enter 手动换行制造停顿感,再加一个副标题,避免第一页下方过空。
保存时文件名用 cca_学号.docx,中间是下划线 _ 而不是减号,保存类型要选 .docx,不要只改后缀。用 Word 打开纯文本会问用哪种编码(UTF-8、GB2312 等),选错了就会乱码。自动检测能选对,是因为文件里带了少量编码元数据。这个问题第四次课讲文本编码时会正式展开。
第二小节:打开计算机硬件的盲盒 · 从人类计算师到数字电子计算机
这一小节为下一节课的数字电路实验做准备。
先纠正一个直觉:计算是一种动作,载体只负责执行。Computer 这个词在早期词典里有两个词条,一个是「电子装置、可变的程序、二进制形式」,另一个是「专门做计算的人」,指那些靠手算吃饭的计算师。把人换成一堆电子元件,计算这件事本身并没有变。计算就是按一套事先定好的规则,把输入的符号变成输出的符号,写成 \(y=f(x)\)。\(f\) 是那套规则,计算是执行它的过程,所以必须有载体;算法是对 \(f\) 的静态描述,可以写成公式(如 \(y=2x+1\))、文字步骤(欧几里得辗转相除法,也可以改写成辗转相减法)、流程图,或者 Python 代码;算力则是载体跑得快不快,人每秒做几次加法,电子计算机每秒做几亿次,差别在载体,不在规则。
希尔伯特曾希望所有数学问题都能机械求解。哥德尔证明完备性不成立,图灵证明可判定性也不成立。这不是人笨,而是符号规则这套体系本身有边界。「不可计算」也不是「题目太难、算力不够」,它指的是根本不存在有限步骤的算法,算力再强也没用。
图灵机是个假想模型,用来严格说清什么叫可计算。一个符号变换规则 \(f\),如果能用图灵机在有限步骤内完成、最后停机给出输出,它就是可计算的。图灵机定义了机械化符号计算,同时划出了所有物理计算机的能力上界。通用图灵机更进一步,把另一台机器的规则和输入数据都编码到纸带上,读进去就能模仿那台机器。想换任务,换纸带就行,硬件不用动。通用计算的念头就来自这里。专用机器就在身边:中国算盘把珠算口诀固化在硬件里,只能做珠算;八音盒的曲子和滚轮绑定,想换曲子就得换滚轮。通用也不等于万能,它能解决的问题仍然限制在可计算问题集合里。
ENIAC(1945)还是专用设备,算起来很快,换任务时却要工作人员重新插线,很慢。EDVAC(1951)由冯·诺依曼主导,提出存储程序架构:程序和数据一样被编码成符号存进存储器,换任务只换程序,不必改硬件,这就是「存储程序、程序控制」。现代通用计算机基本都是这套冯·诺依曼架构,由五大部件组成。图灵机讲的三要素(符号、规则、状态)在这里落到了实处。只要存储够大,两者的可计算能力是等价的,差别只在于纸带可以无限长,而现实中的存储有限。平时说「打开」或「运行」一个程序、一个文档,做的就是把程序或文档从硬盘等外存加载到内存,让 CPU 能直接访问;这也解释了为什么内存断电会丢、硬盘不会。
计算操作的是有限、互不混淆的符号,符号天生离散。从离散符号到选数制,再到用开关承载,最后用电子开关提速,这条线索一路下来,二进制最合适:只要两种物理状态,正好对应开关的通和断,工程上最稳。十进制计算机理论上也能造,但需要十个稳定状态,早期有人试过,不划算。二进制容错最好,也最皮实。开关从继电器、真空管一路走到晶体管,状态切换越来越快,算力也就跟着上来了;继电器其实并不遥远,宿舍门禁刷卡时「啪」一下的电磁锁,本质就是继电器式的开关。从机械开关的毫秒级到电子开关的纳秒级,状态切换速度决定了算力。
把大量开关按固定规则连成网络,就能做符号变换。开关本身只存 0 或 1,连线方式才是变换规则 \(f\)。给一组 0/1,网络就吐出一组 0/1,硬件层面直接完成 \(y=f(x)\)。把这种网络封装起来,就成了逻辑门:与门相当于串联,全 1 才输出 1;或门相当于并联,有 1 就输出 1;非门把 0 变 1、1 变 0。把输入组合和对应输出列成表,就是真值表。与、或、非再组合,还能得到异或门(相同为 0、不同为 1),它是搭加法器的关键。
有了这些逻辑门,就可以用开关电路搭一台会算数的机器,比如算一算 A=1001 和 B=1011 相加。下节课就动手搭半加器和加法器,入口在文末。
✅ 课堂思考与判断
以下题目可用来自测,点击展开查看参考答案。
1. 图灵机是思想概念模型,数字电子计算机是它的现代工程实现。(√ / ×)
√。图灵机是用来定义可计算性的假想模型,数字电子计算机是它在物理世界的实现。
2. 不可计算的问题,只是题目太难,未来算力提升 / AI 就可以解决。(√ / ×)
×。不可计算指的是不存在有限步骤的算法,跟算力大小无关,算力再强也解不了。
3. 通用性 = 什么问题都能解决。(√ / ×)
×。通用说的是换程序就能换任务、不用改硬件,但能力边界仍受可计算性限制,没法解决不可计算的问题。
4. 方程 x² = -4 在实数范围内无解,属于图灵意义下的不可计算问题。(√ / ×)
×。这是特定数域里无解,属于数学限制,不是图灵意义上的不可计算。
5. 晶体管只是电子开关,只承载符号,连线方式(开关网络)才定义变换规则 f,单个开关不能完成计算。(√ / ×)
√。开关只提供 0/1 两种状态,真正构成变换规则 \(f\) 的是开关之间的连线,单个开关什么也算不出来。
6. 什么是存储程序思想?它如何让计算机从「专用计算装置」变为通用计算装置?
存储程序把算法(程序)和数据一样编码成符号存进存储器。运行时从存储器取出指令执行;换任务只需换程序,不必像 ENIAC 那样重新接线,同一台机器因此能处理各种任务。
7. 下节课要用手动拨动的开关搭建半加器。在这个手动电路里,什么代表符号 0/1?什么代表变换规则 f?
开关的接通或断开(也可以看成高低电平)代表 0 和 1;开关之间固定的连线方式,也就是开关网络的拓扑,代表变换规则 \(f\)。
🧪 下节课实验
第 3 次课动手搭数字电路,用基础逻辑门拼出半加器和全加器,再用数码管把结果显示出来。第二小节讲过这些逻辑门,下节课直接上手搭。