第 6 次课 · 感知型数字化:采样、量化与压缩(10.27/10.28)
上次课讲矢量图形,图形规则由人写,画出来精确、可复现。这次课换一类信息:声音、图像、视频。它们的源头是连续变化的物理信号,计算机没法把每个瞬间都存下来,只能隔一段取一个样,再把取到的值归到有限等级上。采样和量化从这一步开始,误差也跟着进来。
一句话概括:感知型数字化用有限样本近似记录连续世界,采样、量化、压缩每一步都在拿精度换体积。
页面完善中
课程视频和课堂回放还没上传,先空着。课件、课堂练习和下面的内容已经整理好。
📺 课程视频
📄 课件
课件说明
课件「信息表示与处理(三)· 感知型编码」共 33 页。前半段讲声音,从波形、频谱、采样讲到奈奎斯特准则和 PCM;后半段讲图像,包括空间采样、亮度与色彩量化、色深和调色板;最后落到无损压缩与有损压缩。课件里还有两道数据量计算和一次手机拍屏幕的观察。
课堂观察 · 手机拍屏幕,为什么会拍到摩尔纹
上课前可以先拿手机试一下。打开相机,对准屏幕上的细密竖条纹,慢慢改变手机和屏幕之间的距离。条纹本身没有动,画面里却会冒出粗的波纹,这就是摩尔纹。
原因不在屏幕,在相机的感光阵列。像素间距和条纹周期接近时,采样网格会把细条纹读成一个频率更低的图案。它和声音里的混叠是同一类问题,采样密度不够,高频细节就会被误认成低频。
课堂计算 · 感知型数据到底有多大
课上算了两笔账。一笔是音频,一笔是那张 3650 亿像素的全景照片。
题目 1 · 一首歌的 PCM 数据量
一首时长 3 分 25 秒的立体声(双声道)歌曲,采样频率 44.1 kHz,每个样本量化位数 16 bit,不做任何压缩。求原始 PCM 音频的数据量(单位:KB)。
参考答案 · 音频
先算时长:\(3 \times 60 + 25 = 205\) 秒。
按 1024 进制换算,大约是 \(35{,}314\) KiB,也就是 \(34.5\) MiB;按十进制约 \(36.2\) MB。
采样率、量化位数、声道数、时长,四个量乘在一起,就是未压缩音频的大小。这也解释了为什么日常音乐几乎都要压缩。
题目 2 · 一张全景图的 BMP 数据量
一张 3650 亿像素的全景照片,如果按 24 bit RGB、无压缩 BMP 格式保存,文件有多大?
参考答案 · 全景图
约 \(1.1\) TB,按 1024 进制约 \(0.996\) TiB。这还没算文件头,也没有压缩。
如果不压缩,这样一张图连打开都费劲,更别说在网上浏览。多媒体要实用,压缩是绕不过去的一步。
📝 作业
这次没有新作业。作业 3「由一张邮票引发的艺术创作」还在收,按第 5 次课的要求提交。
🎬 课堂回放
🗂️ 课程内容摘要
这节课的主线很清楚:连续信号怎么变成 0/1,又为什么一定会丢东西。课堂上先区分逻辑型和感知型,再按声音、图像、压缩三块往下讲。
第 0 部分 · 从逻辑型到感知型
所有信息进计算机前都要数字化,但策略不一样。
| 逻辑型数字化 | 感知型数字化 | |
|---|---|---|
| 输入对象 | 离散符号 | 物理世界连续信号 |
| 核心动作 | 按人为约定的规则编码 | 采样 + 量化 + 编码 |
| 特点 | 精确、无误差、可逆 | 近似记录,存在误差与权衡 |
| 典型例子 | 数值、文本、矢量图形、程序代码 | 图像、声音、视频 |
逻辑型的规则是人定的。A 对应哪个码位、补码怎么表示负数、SVG 里的圆用哪些参数,都有唯一、无歧义的约定。感知型面对的是连续量,采样和量化必然会丢掉一部分信息,所以它一开始就不是无损复刻,而是在可接受的误差内做近似。
计算机只认 0/1,并不知道这串比特代表一段声音还是一张照片。含义仍然来自编码规则,只是这次多了一层「怎么测量」。
第 1 部分 · 感知型数字化的通用流程
声音和图像看起来差得很远,流程其实一样:
连续物理信号 → 采样(时间/空间离散化)→ 量化(幅值/等级离散化)→ 编码(映射成 0/1)
采样是一把时间尺子或空间尺子,决定隔多久、隔多远取一个点。量化是一把幅值尺子,把连续值就近归到有限刻度上。编码再把这些刻度映射成二进制。解码时反过来走一遍,硬件就能重建声音或画面。
所以有两句话:离散化等于采样加量化,数字化等于离散化加编码。
声音是一维时域信号,采样发生在时间轴上。图像是二维空域信号,采样发生在平面上。视频可以看成按时间排列的图像序列,再加一路同步的声音。
| 信息类型 | 信号维度 | 采样对象 | 量化对象 |
|---|---|---|---|
| 声音 | 一维(时间) | 时间点 | 声波幅值 |
| 图像 | 二维(空间) | 像素位置 | 亮度、色彩分量 |
| 视频 | 三维(空间 + 时间) | 像素位置 + 帧时刻 | 亮度、色彩分量 |
第 2 部分 · 声音采样与奈奎斯特准则
课上放了一段鸟鸣。看时域波形,只能看到一条不规则的振动曲线,很难说清里面有哪些成分。换成频谱图就清楚了:低频的基频决定音调,高频的谐波决定音色。
数字化时,不可能记录曲线上每一个点,只能按固定间隔取样。取太快,数据量大;取太慢,会认错频率。
采样太慢会导致混叠。当采样频率低于信号最高频率的两倍时,高频成分会被误判成一个更低的频率。这个虚假的低频就是高频信号的别名,混进原始声音后,真假低频叠在一起,再也分不开。
课件里用单一频率的正弦波做了三组对比:
- 每周期只采一个点。如果每次都落在同一相位,波形看起来没有变化,会被读成 0 Hz。
- 每周期采两个点。刚好卡在临界。落在波峰、波谷时碰巧能读出原频率,落在零点时,波动信息可能直接丢掉。
- 每周期采两个以上的点。采样频率大于最高频率的两倍,才能稳定识别频率,避免混叠。
奈奎斯特准则说的就是这件事:采样频率必须大于信号中最高频率分量的 2 倍。
采样率的一半 \(f_s/2\) 也叫奈奎斯特频率,它是系统能稳定记录的最高频率:
这里容易误解。2 倍只是下限,不是随便采两个点就稳。工程上还会在 ADC 前面加一级低通滤波,把高于 \(f_s/2\) 的成分先滤掉,再采样。因为一旦混叠,虚假频率已经和真实信号混在一起,后面再想办法也分不干净。
人耳能听到的频率大约是 20 Hz 到 20 kHz,所以采样率至少要超过 40 kHz。常见的选择有这些:
| 采样率 | 常见场景 | 能稳定记录的最高频率 |
|---|---|---|
| 8,000 Hz | 电话音质,保留语音核心频段 | 4,000 Hz |
| 11,025 Hz | 低音质音频 | 5,512.5 Hz |
| 22,050 Hz | 中音质、FM 收音机级 | 11,025 Hz |
| 44,100 Hz | CD 级音频 | 22,050 Hz |
| 48,000 Hz 及以上 | 数字电视、DVD、专业影音 | 24,000 Hz 及以上 |
44.1 kHz 能覆盖人耳 20 kHz 的上限,还给抗混叠滤波器留了一段过渡带,所以成了数字录音里最常见的采样率之一。采样率越高,能记录的频率越高,同样时长的数据也越多。
第 3 部分 · 量化、音频编码与数据量
采样只解决了什么时候取点,取到的幅值仍然是连续值。量化要把这些连续幅值归到有限个台阶上。
- 8 bit 量化:\(2^8 = 256\) 个台阶。
- 16 bit 量化:\(2^{16} = 65{,}536\) 个台阶。
台阶越多,波形复刻得越细,量化误差越小,每个样本占的比特也越多。量化误差最大约为半个台阶,听感上就是底噪。位数太低时,安静段落的细节会被抹平。
音频样本是一串带有时序的符号。样本的先后顺序本身就代表时间,不需要再单独编码时间;每个样本真正要编码的,是它对应的幅值台阶。
从声音到 WAV 文件的流程大致是这样:
麦克风 → 连续模拟电信号 → 抗混叠低通 → 采样 → 量化 → 编码 → WAV(PCM + 元数据)
完成采样、量化、编码的硬件叫 A/D 转换器,也就是 ADC。WAV 里通常存的是 PCM 原始音频,没有压缩,文件头还要记录采样率、量化位数和声道数。播放器拿到这三个参数,才知道该怎么还原。
音频数据量的公式:
课堂上那首歌算出来约 36.2 MB。一分钟左右的立体声 CD 音质音频,也要十几 MB。不压缩的话,存储和传输都吃不消,所以日常音乐普遍用 MP3、AAC 这类有损格式。
第 4 部分 · 图像的空间采样与分辨率
图像用像素阵列记录画面。像素是能被独立赋予颜色和亮度的最小单位,来源可以是相机、扫描仪,也可以是屏幕截图。
图像因此有三个特点。细节丰富,每个像素都能单独设颜色和亮度,适合还原照片和实景。缩放会失真,放大时像素被拉伸,细节变模糊,缩小时会丢掉部分像素。文件量大,分辨率越高、颜色越丰富,占的空间越多。
图像数字化的采样发生在空间上。以数码相机为例,CMOS 传感器上排着几百万甚至上亿个光敏单元,每个单元就是一个采样点。快门打开时,各单元把对应位置的光强转成电信号,芯片按顺序读出,再经过 A/D 转换,得到像素阵列。
1920×1080、24 bit 真彩色的一帧,未压缩约 6.2 MB。一秒 30 帧就是 186 MB 左右。视频如果不压缩,数据量会很快失控。
空间采样也会混叠。像素间距相对于画面细节太粗时,细密纹理会被采样成粗大的虚假图案,这就是摩尔纹。手机拍屏幕时,屏幕像素网格和相机感光阵列两套周期结构叠在一起,很容易出现。
分辨率怎么选,不只看技术。还要看人眼在正常观看距离下能不能分辨,看文件要占多少空间,看用在哪里。
| 分辨率 | 像素数 | 特点 |
|---|---|---|
| 标清 720P | 1280×720 | 小屏清楚,大屏略欠细腻 |
| 全高清 1080P | 1920×1080 | 细节饱满,锯齿不明显 |
| 超高清 4K | 3840×2160 | 近距离细节足,色彩过渡自然 |
采样太少,会混叠、出摩尔纹和锯齿。采样太多,超出人眼的分辨极限,就只是感知冗余,白占存储和带宽。
所以分辨率说的是采样密度,不是画面质量的唯一指标。同样像素数,传感器尺寸、镜头、降噪和压缩算法都会影响最终观感。
第 5 部分 · 亮度量化与色彩量化
像素里有两类量化信息:亮度和色彩。
灰度量化用的还是那把幅值尺子。光的明暗是连续量,把它切成有限等级,就是灰度。最常见的 8 bit 灰度把最暗到最亮分成 256 个台阶,用 00000000 到 11111111 表示。
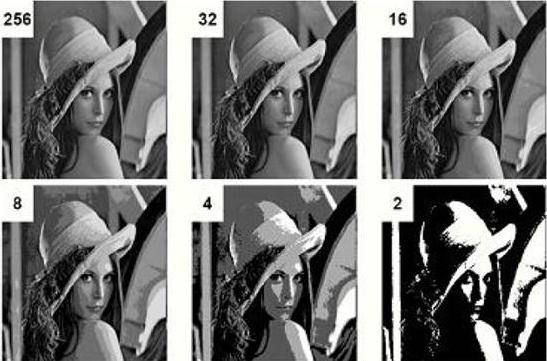
位数越低,能用的灰度越少,画面会出现色带。人眼对亮度的分辨能力有限,8 bit 在大多数观看条件下已经足够顺滑,再往上加,收益越来越小,文件却更大。
色彩要复杂一些。不同颜色的光来自不同频率的电磁波,但人眼不会直接分辨成千上万种波长。视网膜上有三类感光细胞,分别对蓝、绿、红最敏感,大脑靠三路信号的强弱组合,合成我们看到的颜色。数字化时仿照人眼,用三把独立的亮度尺子记录红、绿、蓝,这就是 RGB 三基色方案。
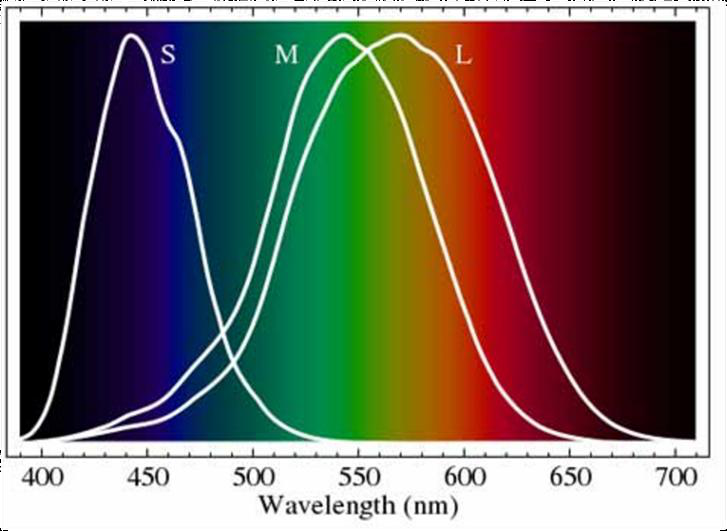
1861 年,麦克斯韦用红、绿、蓝三张滤色片叠加,做出了第一张彩色照片。这也是分色加幅度量化最早的实践之一。
数码相机怎么采颜色?传感器本身只测光强,不分颜色,所以在前面加一层滤光层。每个感光点只采一种基色,把这一路的电信号量化成 0 到 255。一个像素缺的两个分量,再用相邻点的数据插值补出来。
最常见的排布是拜尔阵列,2 绿、1 红、1 蓝。绿色点更多,因为人眼对绿光的亮度和细节更敏感。这套分工采样加插值补全的方案,是传感器在成本、体积和画质之间做的折中。
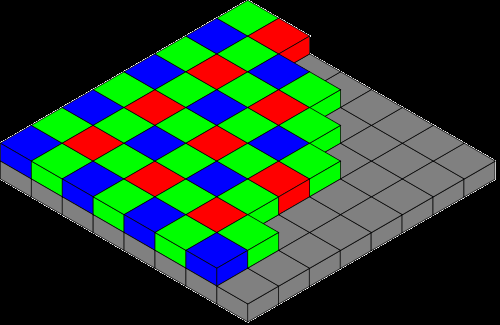
相机里的 RAW 是传感器原始采样数据,通常是拜尔单色点阵。经过插值补齐 RGB,再做机内处理和压缩,才得到日常用的 JPG。RAW 保留的信息多,后期空间大,文件也大;JPG 直接可用,体积小,但有一部分信息已经回不来了。
色深表示每个像素用多少位记录颜色。
| 图像类型 | 颜色深度 | 说明 |
|---|---|---|
| 黑白图 | 1 bit | 只有黑、白两级 |
| 灰度图 | 8 bit | 256 级亮度 |
| RGB 8 色图 | 3 bit | 每个通道 1 bit,共 8 种颜色 |
| 索引 16 色图 | 4 bit | 引入调色板,共 16 种颜色 |
| 索引 256 色图 | 8 bit | 调色板 256 色 |
| 真彩色图 | 24 bit | 每个通道 8 bit,约 1677 万种颜色 |
调色板的做法很直接。先统计一张图里出现过哪些颜色,按出现次数排序,挑出最重要的一批存进颜色表。图像本体不再为每个像素存完整 RGB,只存一个索引号,查表就能找到颜色。表里的每一条仍然是完整的 RGB 描述,颜色模型没变,只是换了一种更省空间的存法。
下面两张图可以对照着看。前一张把每个像素压到 4 bit,调色板里最多只有 16 个颜色槽位。照片里的天空、脸颊和帽子原本有大量相近的过渡色,现在只能就近归到有限的十几种颜色里,于是出现一块一块的色阶,色带很明显。
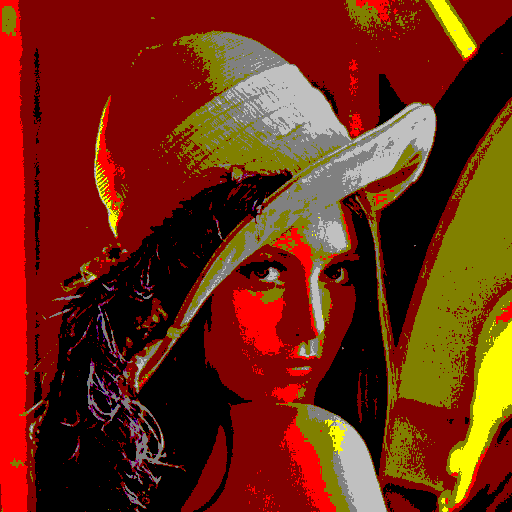
后一张是 24 bit 真彩色,红、绿、蓝各占 8 bit,一个像素能选约 1677 万种组合。同一张照片,肤色和背景的过渡就连续得多,肉眼很难再看出台阶。
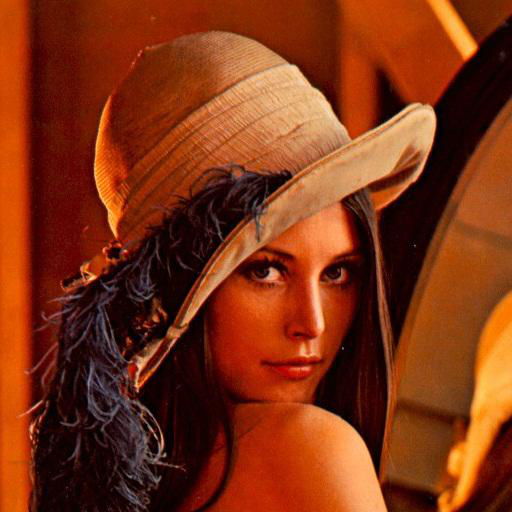
两张图的差别不是内容变了,而是每个像素能分到多少种颜色。色深越高,过渡越顺,文件也越大。色深低适合图标、简单插画这类颜色本来就不多的画面;照片通常要用 24 bit 真彩色,或者用质量较高的有损压缩,把不易察觉的颜色细节去掉。
课上还看了勃朗峰 3650 亿像素的全景照片。采样越密、量化越细,细节越多,文件也越大。那张图按 24 bit 无压缩 BMP 存,超过 1 TB,不压缩根本没法用。
第 6 部分 · 压缩编码:无损与有损
多媒体数据一多,压缩就不是可选项。香农的信息论给了一个基本框架:
\(I\) 是真正携带的信息量,\(D\) 是采样、量化后直接得到的数据量,\(D_u\) 是冗余。信息的作用是消除不确定性,香农熵给出的就是信息量的理论下限:
采样量化得到的数据量通常大于信息量,多出来的部分就是冗余。压缩编码要做的,是设计更紧凑的映射,把冗余去掉,让数据量尽量靠近这个下限。
| 无损压缩 | 有损压缩 | |
|---|---|---|
| 原理 | 去除统计冗余 | 去除统计冗余和感知冗余 |
| 能否还原 | 可以完全恢复 | 不能 100% 还原 |
| 常见压缩比 | 约 2:1 到 5:1 | 通常高得多 |
| 典型格式 | PNG、FLAC、WAV、ZIP | JPG、MP3、WMA、MP4 |
| 适用场景 | 文本、程序、需要反复编辑的图像、追求原汁原味的音频 | 照片分享、在线音频、网络视频 |
无损压缩只利用数据内部的重复和规律,解压后能完全恢复,所以适合文本、程序、工程文件,以及需要反复编辑的图像。代价是压缩比有限。
有损压缩除了去统计冗余,还会根据人眼、人耳的感知特性,主动丢掉分辨不出来的细节。解压后无法完全还原,但在合适参数下,主观感受差别很小,压缩比可以做得更高。
感知型数据其实有两笔损失。一笔是量化误差,在采样、量化阶段就产生了,是记录精度不够。另一笔是有损压缩的主动损失,在编码阶段为了减小体积,主动丢掉感知上不重要的信息。两笔账发生在不同环节,不要混在一起。
第 7 部分 · 参数怎么选
回头看,采样率、分辨率、量化位数、色深、压缩质量,这些参数没有一组放之四海皆准。提高精度,数据量就上去;压缩得狠,细节就可能回不来。最后还是要看人能不能分辨,以及这个文件要拿来做什么。
电话语音不需要 CD 音质,手机预览不需要 3650 亿像素,归档保存则可能宁愿多占空间,也不要有损压缩。逻辑型编码追求唯一、无歧义,感知型编码追求在人的感知范围内用尽量少的数据近似。这个区别,后面的图像处理和生成式 AI 还会反复遇到。
核心概念
| 概念 | 要点 |
|---|---|
| 感知型数字化 | 对连续物理信号做采样、量化、编码,用有限样本近似记录真实世界 |
| 采样 | 在时间或空间上按固定间隔取点,决定记多密 |
| 量化 | 把连续幅值归到有限台阶,决定记多细 |
| 离散化 | 采样加量化,把连续信号变成有限离散样本 |
| 编码 | 把离散样本映射成二进制比特串 |
| 奈奎斯特准则 | 采样频率必须大于信号最高频率的 2 倍,才能避免混叠 |
| 奈奎斯特频率 | \(f_s/2\),采样系统能稳定记录的最高频率 |
| 混叠 | 采样不足时高频被误判成低频,产生虚假频率且无法事后分离 |
| 抗混叠滤波 | 采样前用低通滤波器滤掉高于 \(f_s/2\) 的成分 |
| 采样率 | 每秒采样次数,单位 Hz,决定能记录多高的频率 |
| 量化位数 | 每个样本或每个颜色分量用多少 bit 表示 |
| 量化误差 | 连续值归到有限台阶时产生的误差,最大约半个台阶 |
| PCM | 直接存储采样、量化后原始样本的编码,无压缩 |
| WAV | 常见音频容器,内部常承载 PCM,并记录采样率、位深、声道数 |
| 像素 | 图像中能被独立赋予颜色和亮度的最小单位 |
| 分辨率 | 图像的像素数量,本质是空间采样密度 |
| 摩尔纹 | 空间采样不足或两套周期结构叠加产生的虚假低频图案 |
| 灰度 | 只用亮度表示的图像,8 bit 灰度有 256 级 |
| 色深 | 每个像素用于记录颜色的比特数 |
| RGB | 用红、绿、蓝三路分量组合表示颜色,仿照人眼三色视觉 |
| 拜尔阵列 | 相机滤色层按 2 绿、1 红、1 蓝排布,每个感光点只采一种基色 |
| 去马赛克 | 用相邻像素的基色数据插值,补齐每个像素缺失的 RGB 分量 |
| 调色板 | 用颜色表加索引号代替逐像素完整 RGB,减少数据量 |
| 信息熵 | 信息量的理论下限,用于衡量一段数据真正携带多少信息 |
| 冗余 | 数据量中超出信息量的部分,是压缩的对象 |
| 无损压缩 | 可完全还原,去除统计冗余,如 PNG、FLAC、ZIP |
| 有损压缩 | 不可完全还原,去除统计冗余和感知冗余,如 JPG、MP3、MP4 |
✅ 课堂思考与判断
下面几道题可以自测,点开看答案。
1. 感知型数字化和逻辑型数字化,最根本的区别是什么?
逻辑型处理的是离散符号,规则由人定,编码唯一、无歧义、无误差。感知型处理的是连续信号,靠采样和量化得到有限样本,只是对真实世界的近似,必然有误差和权衡。
2. 采样和量化分别解决什么问题?
采样管时间或空间,决定隔多久、隔多远取一个点。量化管幅值或颜色,决定把连续值归到多少个等级。两者合起来叫离散化。
3. 为什么采样频率要大于信号最高频率的 2 倍?
采样点太少,重建时无法唯一确定原始波形的频率,高频会被误判成低频,产生混叠。大于 2 倍,每个周期才有足够多的采样点,最高频率成分才能稳定识别。
4. 每周期 1 个采样点、2 个采样点分别会怎样?
每周期 1 个点,如果每次都落在同一相位,波形看起来没有变化,可能被读成 0 Hz。每周期 2 个点刚好在临界,落在波峰、波谷时碰巧能恢复,落在零点时可能丢失波动信息。所以 2 倍是下限,实际要留余量。
5. 什么是混叠?为什么采样后不能靠算法完全消除?
混叠是采样不足时,高频被读成低频,产生原本不存在的虚假频率。采样之后,虚假频率已经和真实低频混在一起,算法分不清哪部分是信号、哪部分是别名。要避免只能提前在采样前做低通滤波。
6. 44.1 kHz 采样率能记录的最高频率是多少?为什么常见数字录音选它?
\(44{,}100\) 的一半是 \(22{,}050\) Hz。它覆盖了人耳约 20 kHz 的听觉上限,还给抗混叠滤波器留了过渡带,所以成了 CD 等数字录音的常用采样率。
7. 8 bit 和 16 bit 量化有什么区别?
8 bit 有 256 个幅值台阶,16 bit 有 65,536 个。位数越高,量化越细,量化误差和底噪越小,但每个样本占的比特更多,文件更大。
8. 3 分 25 秒、44.1 kHz、16 bit、双声道的 PCM 音频有多大?
时长 205 秒,数据量是 \(205 \times 44100 \times 2 \times 16 \div 8 = 36{,}162{,}000\) 字节,约 35,314 KiB,也就是 34.5 MiB,十进制约 36.2 MB。
9. 图像的空间采样在相机里对应什么硬件过程?
CMOS 传感器上排着大量光敏单元,每个单元是一个采样点。快门打开时,各单元把对应位置的光强转成电信号,芯片按顺序读出,再经 A/D 转换得到像素阵列。
10. 手机拍屏幕出现摩尔纹,说明条纹变了吗?
没有。条纹本身没变,是相机感光阵列的空间采样和屏幕条纹周期叠加,采样不足时把细条纹读成了粗图案。它和声音混叠是同一类采样问题。
11. 分辨率越高越好吗?
不是。分辨率越高,细节越多,文件、带宽和计算量也越大。超过人眼在正常观看距离下的分辨极限后,再提高只是感知冗余。选分辨率要看观看距离、屏幕尺寸、用途和存储成本。
12. 8 bit 灰度有多少级亮度?为什么通常用 8 bit?
8 bit 有 256 级。人眼在常见观看条件下对亮度的分辨能力有限,256 级已经能比较顺滑地表现明暗过渡,位数再高收益越来越小,文件却更大。
13. 24 bit 真彩色能表示多少种颜色?
每个 RGB 通道 8 bit,一共 \(2^{24} = 16{,}777{,}216\) 种颜色,约 1677 万种。
14. 拜尔阵列为什么让绿色感光点是红色、蓝色的两倍?
人眼对绿光的亮度和细节更敏感。增加绿色采样点,能在成本不明显增加的情况下保留更多亮度细节,缺的红色、蓝色再靠相邻点插值补。
15. RAW 和 JPG 有什么区别?
RAW 是传感器原始采样数据,通常是拜尔单色点阵,保留的信息多,后期空间大,文件也大。JPG 经过插值、机内处理和压缩,直接可用、体积小,但部分信息不可逆地丢了。
16. 调色板图像为什么能减小体积?它还是 RGB 吗?
调色板先统计图中出现过的颜色,把少量代表色存成颜色表,图像本体只存索引号,不再为每个像素存完整 RGB。表里的每一条仍然是 RGB 描述,只是存储方式更紧凑。
17. 3650 亿像素、24 bit 的 BMP 有多大?说明了什么?
\(3650\times10^8 \times 24 \div 8 = 1.095\times10^{12}\) 字节,约 1.1 TB。高分辨率、高色深的原始图像数据量非常大,多媒体要实用必须压缩。
18. 信息熵和冗余是什么关系?
信息熵是一段信号真正携带的信息量下限。采样、量化直接得到的数据量通常比它大,超出的部分就是冗余。压缩就是尽量去掉冗余,让数据量靠近信息熵。
19. 无损压缩和有损压缩有什么区别?各举两个格式。
无损压缩只去统计冗余,解压后能完全恢复,比如 PNG、FLAC、ZIP。有损压缩还会根据人眼、人耳的感知特性主动丢细节,解压后不能完全还原,比如 JPG、MP3、MP4。
20. 量化误差和有损压缩造成的损失是一回事吗?
不是。量化误差在采样、量化阶段就产生了,是有限台阶造成的记录精度损失。有损压缩的损失在编码阶段,是为了减小体积主动丢信息。两者都会让数据无法完全还原,但环节和原因不同。
21. 为什么说感知型数字化是工程权衡?
采样率、分辨率、量化位数、色深和压缩方案都影响细节、体积和计算成本。提高精度通常意味着更大的数据量,压缩太狠又可能丢掉有用信息。没有绝对最优的参数,只能按人的感知极限和实际场景选一套够用的组合。
22. 矢量图和位图缩放时表现不同,根源是什么?
矢量图存的是几何规则和坐标参数,缩放时按新比例重新计算、重新绘制,所以不会失真。位图存的是固定像素阵列,放大只是把像素拉大,所以会糊、会出马赛克。前者属于逻辑型编码,后者属于感知型数字化。